

Trong thư viện Hugging Face Transformers, hai khái niệm quan trọng là pipeline và tokenizer. Chúng đóng vai trò khác nhau trong quá trình xử lý văn bản và triển khai các mô hình học sâu cho xử lý ngôn ngữ tự nhiên (NLP).
1. Pipeline
Pipeline là một tính năng rất tiện lợi và mạnh mẽ được cung cấp bởi thư viện Hugging Face Transformers. Nó cho phép bạn dễ dàng thực hiện các tác vụ NLP khác nhau chỉ với một vài dòng mã. Pipeline hoạt động như một giao diện cấp cao, giúp người dùng nhanh chóng sử dụng các mô hình đã được huấn luyện để giải quyết nhiều tác vụ NLP phổ biến như:
- Text Classification (phân loại văn bản)
- Sentiment Analysis ( phân tích cảm xúc)
- Named Entity Recognition (NER) (nhận dạng thực thể)
- Question Answering (trả lời câu hỏi)
- Text Summarization (tóm tắt văn bản)
- Translation (dịch văn bản)
- Text Generation (tạo văn bản)
Cách sử dụng pipelinerất đơn giản. Bạn chỉ cần chỉ định tác vụ mình muốn thực hiện và pipeline sẽ chọn mô hình phù hợp để thực hiện tác vụ đó.
Ví dụ về việc sử dụng pipelinephân tích chỉ số cảm xúc trong câu ” I’m super excited to be on the way to LLM mastery!”, ứng dụng của Sentiment Analysis ( phân tích chỉ số cảm xúc)
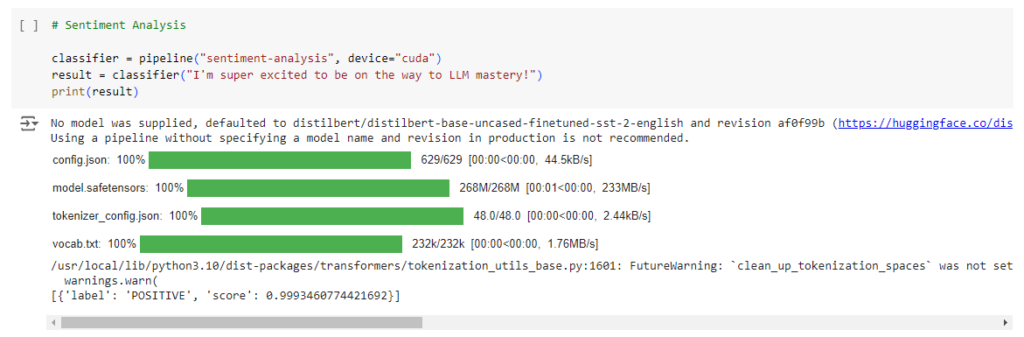
=> Đoạn code trong hình sử dụng thư viện Hugging Face Transformers cho các tác vụ xử lý ngôn ngữ tự nhiên (NLP) với GPU (CUDA). Kết quả trả về là POSITIVE và score là 0.999, gần như chính xác 99%.
Một ví dụ khác sử dụng pipeline trong Text Summarization (tóm tắt văn bản)

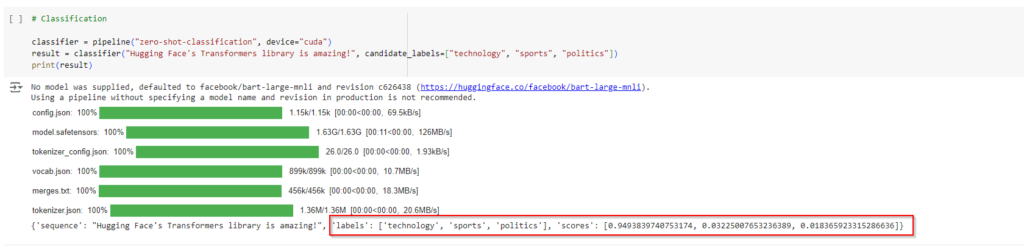
Hay sử dụng Pipeline để Text Classification (phân loại văn bản)
Tạo audio từ text

Trong các ví dụ trên, pipeline tự động tải mô hình đã được huấn luyện phù hợp để tóm tắt văn bản, tạo nội dung, phân tích cảm xúc,…giúp tiết kiệm thời gian và giảm độ phức tạp trong việc lựa chọn và triển khai mô hình.
2. Tokenizer
Tokenizer là một thành phần quan trọng trong xử lý ngôn ngữ tự nhiên. Nó có nhiệm vụ chuyển đổi văn bản thành các token, để có thể sử dụng làm đầu vào cho mô hình học sâu (Deep learning). Token có thể là từ, cụm từ hoặc một phần của từ, tùy thuộc vào thuật toán tokenizer.
Trong thư viện Transformers, mỗi mô hình đi kèm với một tokenizer riêng phù hợp với cấu trúc và yêu cầu của mô hình đó. Tokenizer thực hiện những công việc chính sau:
- Chia nhỏ văn bản thành các token: Tokenizer sẽ chia văn bản thành những đơn vị nhỏ hơn mà mô hình có thể xử lý.
- Mã hóa token thành số nguyên: Sau khi chia nhỏ văn bản thành token, tokenizer sẽ chuyển đổi các token này thành các số nguyên mà mô hình có thể hiểu được.
- Thêm các đặc trưng đặc biệt (padding, attention masks): Tokenizer cũng đảm bảo rằng đầu vào có kích thước phù hợp và thêm các đặc trưng đặc biệt như token bắt đầu và kết thúc, hoặc padding để đảm bảo rằng các đầu vào có cùng kích thước.
Ví dụ về việc sử dụng Tokenizer:

Trong ví dụ trên, chúng ta sử dụng mô hình meta-llama/Meta-Llama-3.1-8B của Meta, gọi hàm tokenizer sẽ chuyển văn bản "I am excited to show Tokenizers in action to my LLM engineers" thành một chuỗi các token, và mỗi token sẽ được chuyển thành số nguyên mà mô hình Meta-Llama-3.1-8B có thể xử lý.
Vai trò của Pipeline và Tokenizer trong quy trình NLP
- Tokenizer thường được sử dụng trước khi đưa dữ liệu vào mô hình. Nó chuẩn bị văn bản, chuyển thành dạng mà mô hình có thể hiểu được.
- Pipeline giúp đơn giản hóa toàn bộ quá trình: từ việc tokenization, tính toán suy luận bằng mô hình. Bạn không cần phải tự mình quan tâm đến từng bước riêng biệt.
Tóm lại, pipeline là một giao diện cấp cao để thực hiện các tác vụ NLP mà không cần hiểu rõ chi tiết về mô hình, trong khi tokenizer là bước đầu tiên quan trọng để chuẩn bị dữ liệu trước khi đưa vào mô hình.
Tìm hiểu chi tiết tại:
https://huggingface.co/docs/transformers/main_classes/pipelines
https://huggingface.co/docs/diffusers/en/api/pipelines/overview





hoang
bài viết khá chi tiết, genAI hiện tại là vua mọi ngành :))